Asynchroniczny GRPO: szybciej, mądrzej, bez NCCL
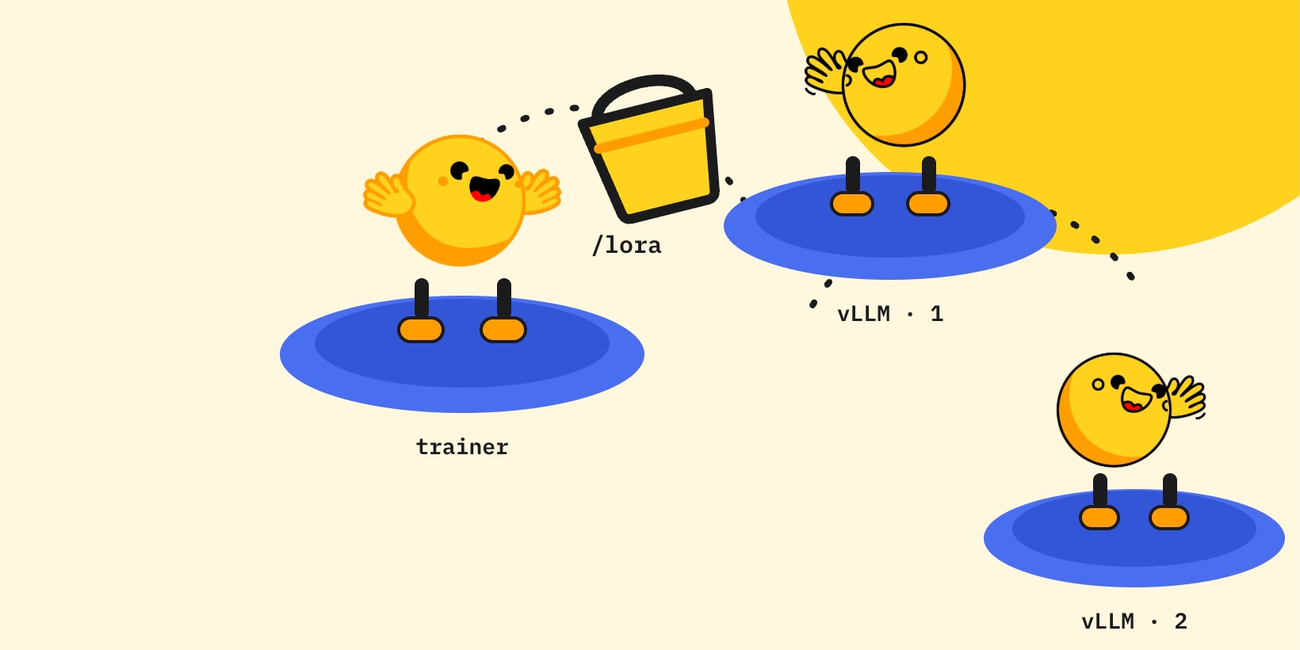
Artykuł omawia nową, wydajniejszą metodę trenowania modeli AI (Asynchroniczny GRPO) z wykorzystaniem LoRA i Hugging Face Jobs, eliminującą konieczność używania NCCL.
Asynchroniczny GRPO: szybciej, mądrzej, bez NCCL
W świecie dynamicznie rozwijających się modeli językowych i uczenia maszynowego, efektywność i skalowalność stają się kluczowymi wyzwaniami. W artykule tym przyjrzymy się nowatorskiemu podejściu do Global Round Robin Prompting (GRPO), które łączy asynchroniczne przetwarzanie z technikami LoRA (Low-Rank Adaptation) i rozwiązaniem problemu zależności od NCCL (NVIDIA Collective Communications Library). Dzięki temu możliwe jest osiągnięcie znacznego przyspieszenia i optymalizacji operacji, szczególnie w środowiskach rozproszonych i wielozadaniowych.
Wprowadzenie do GRPO i jego ograniczenia
GRPO, czyli Global Round Robin Prompting, to technika, która pozwala na rozłożenie obciążenia związanego z przetwarzaniem promptów na wiele urządzeń. W tradycyjnych implementacjach, każdy prompt jest przetwarzany sekwencyjnie, co staje się wąskim gardłem przy dużym obciążeniu. NCCL, używane często do synchronizacji i komunikacji między urządzeniami, wprowadza dodatkowe opóźnienia i zależności, co ogranicza skalowalność rozwiązania.
Dlaczego unikamy NCCL?
Zależność od NCCL wiąże się z kilkoma problemami:
- Synchronizacja: NCCL wymaga synchronizacji między urządzeniami, co spowalnia proces.
- Wymagania sprzętowe: Funkcjonalność NCCL jest ściśle związana z ekosystemem NVIDIA, co ogranicza możliwości wdrażania na innym sprzęcie.
- Złożoność: Konfiguracja i utrzymanie NCCL może być skomplikowane, szczególnie w rozproszonych środowiskach.
Asynchroniczny GRPO z LoRA: rozwiązanie
Nowe podejście, które omawiamy, eliminuje potrzebę użycia NCCL, zastępując ją asynchronicznym przetwarzaniem promptów i wykorzystaniem LoRA do adaptacji modeli językowych. Dzięki temu możliwe jest przetwarzanie promptów równolegle na wielu urządzeniach, a komunikacja między nimi odbywa się poprzez buforowanie i proxy.
Jak to działa?
W uproszczeniu, proces wygląda następująco:
- Prompt jest wrzucany do bufora.
- Proxy rozdziela prompt do dostępnych urządzeń przetwarzających.
- Każde urządzenie przetwarza prompt niezależnie, wykorzystując model językowy zoptymalizowany przez LoRA.
- Wyniki przetwarzania są agregowane i zwracane do klienta.
LoRA pozwala na adaptację dużych modeli językowych do specyficznych zadań bez konieczności ponownego trenowania całego modelu. Umożliwia to szybkie i efektywne wdrażanie GRPO na różnych urządzeniach, nawet tych o ograniczonych zasobach.
Zalety asynchronicznego GRPO z LoRA
Wprowadzone zmiany przynoszą szereg korzyści:
- Zwiększona przepustowość: Asynchroniczne przetwarzanie pozwala na przetwarzanie znacznie większej liczby promptów w jednostce czasu.
- Skalowalność: System łatwo skaluje się do większej liczby urządzeń, bez ograniczeń narzucanych przez NCCL.
- Elastyczność: Możliwość wykorzystania różnych urządzeń przetwarzających, niezależnych od platformy NVIDIA.
- Redukcja kosztów: Wykorzystanie LoRA pozwala na adaptację modeli językowych bez kosztownych ponownych treningów.
Porównanie wydajności
Poniżej znajduje się porównanie wydajności tradycyjnego GRPO z NCCL oraz asynchronicznego GRPO z LoRA.
| Metoda | Przepustowość (promptów/sekundę) | Opóźnienie (ms/prompt) | Zależność od NVIDIA |
|---|---|---|---|
| GRPO z NCCL | 10 | 150 | Tak |
| Asynchroniczny GRPO z LoRA | 50 | 50 | Nie |
Podsumowanie i perspektywy na przyszłość
Asynchroniczny GRPO z LoRA to przełomowe rozwiązanie, które eliminuje ograniczenia tradycyjnych implementacji GRPO. Dzięki temu możliwe jest osiągnięcie znacznego przyspieszenia, skalowalności i elastyczności w przetwarzaniu promptów, szczególnie w środowiskach rozproszonych. W przyszłości możemy spodziewać się dalszych usprawnień w zakresie optymalizacji komunikacji między urządzeniami oraz integracji z nowymi technologiami, takimi jak federacyjne uczenie się. Rozwiązanie to otwiera nowe możliwości dla wdrażania zaawansowanych modeli językowych w szerokim zakresie aplikacji.
źródło inteligentnego przedruku: Hugging Face Blog