LFM2.5-VL-DSpark: Turbo dla modeli wizyjno-językowych
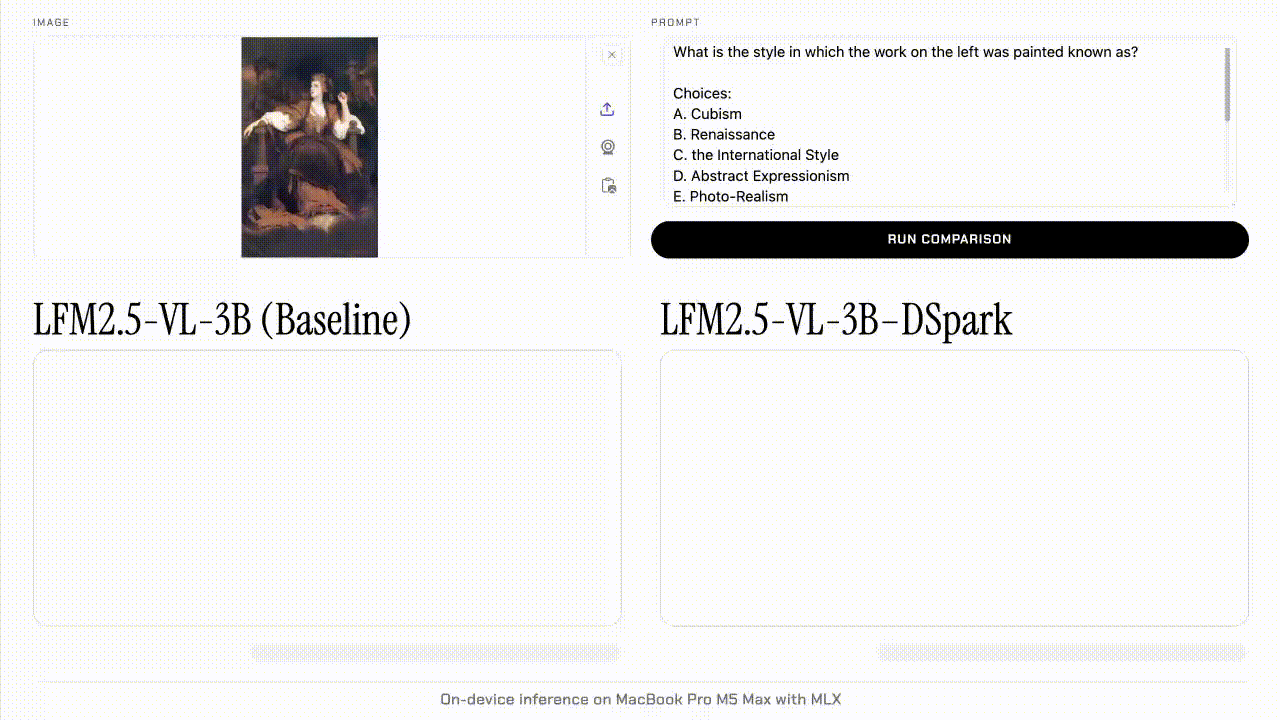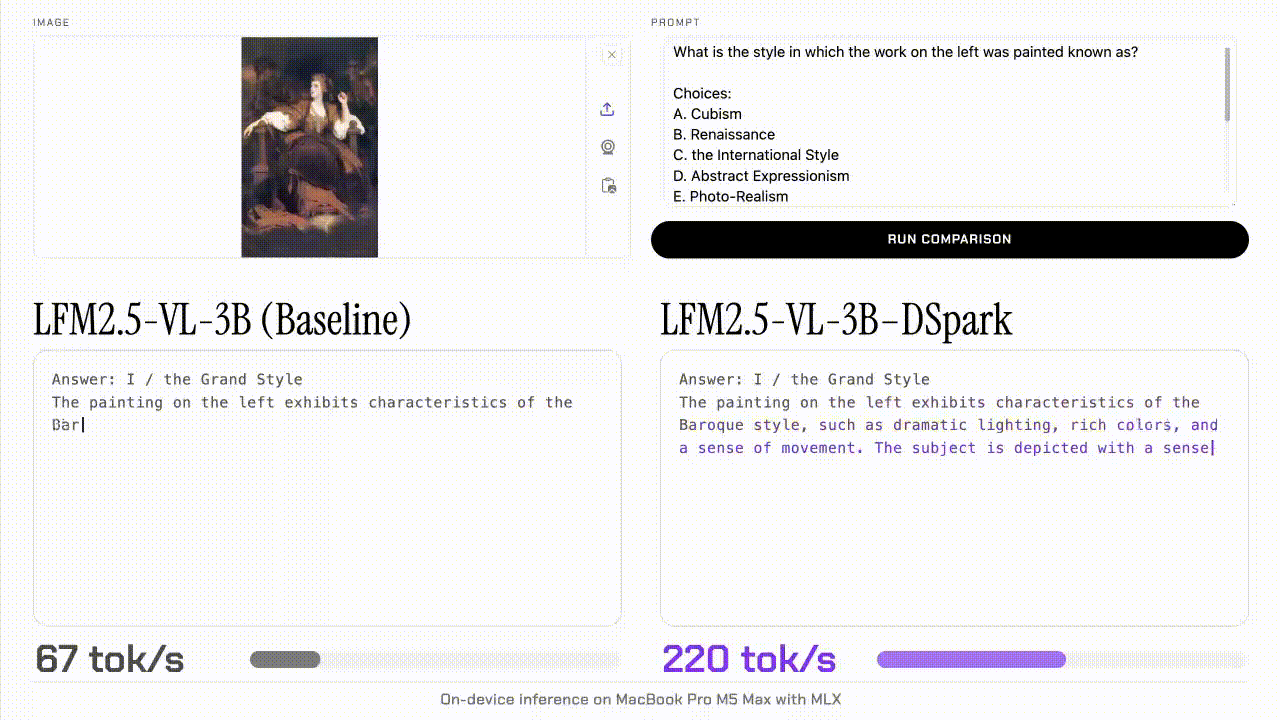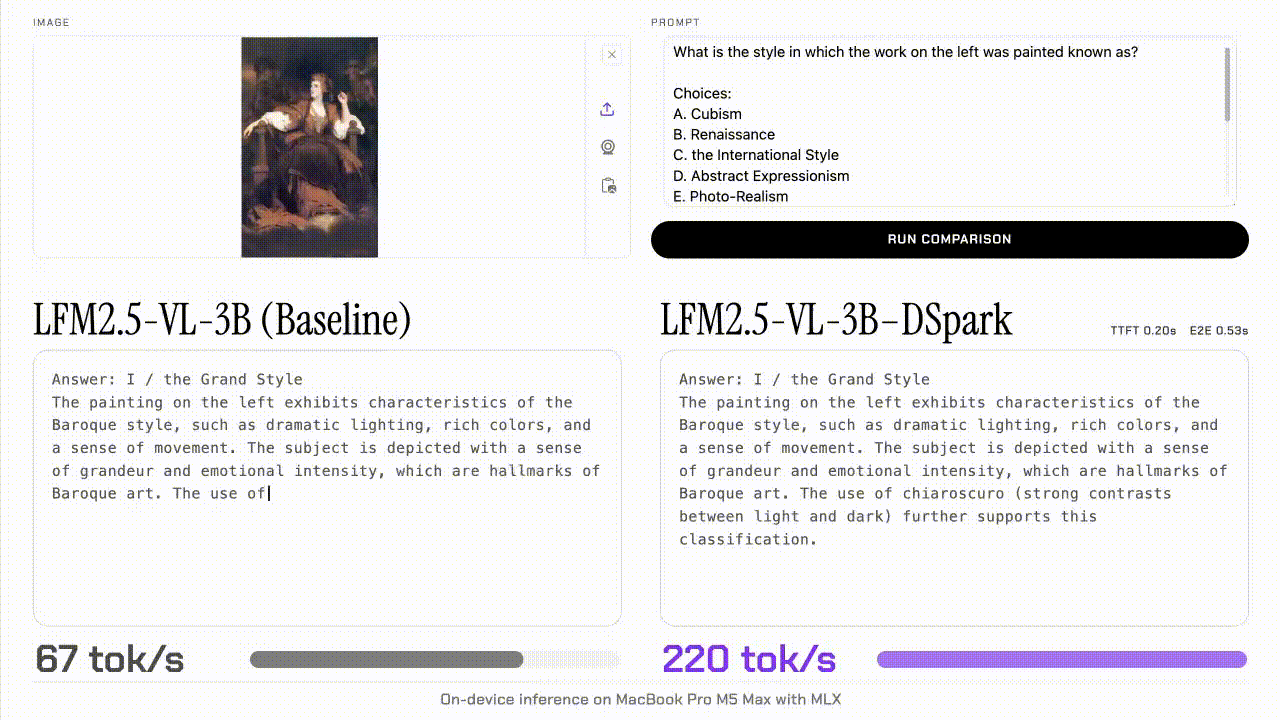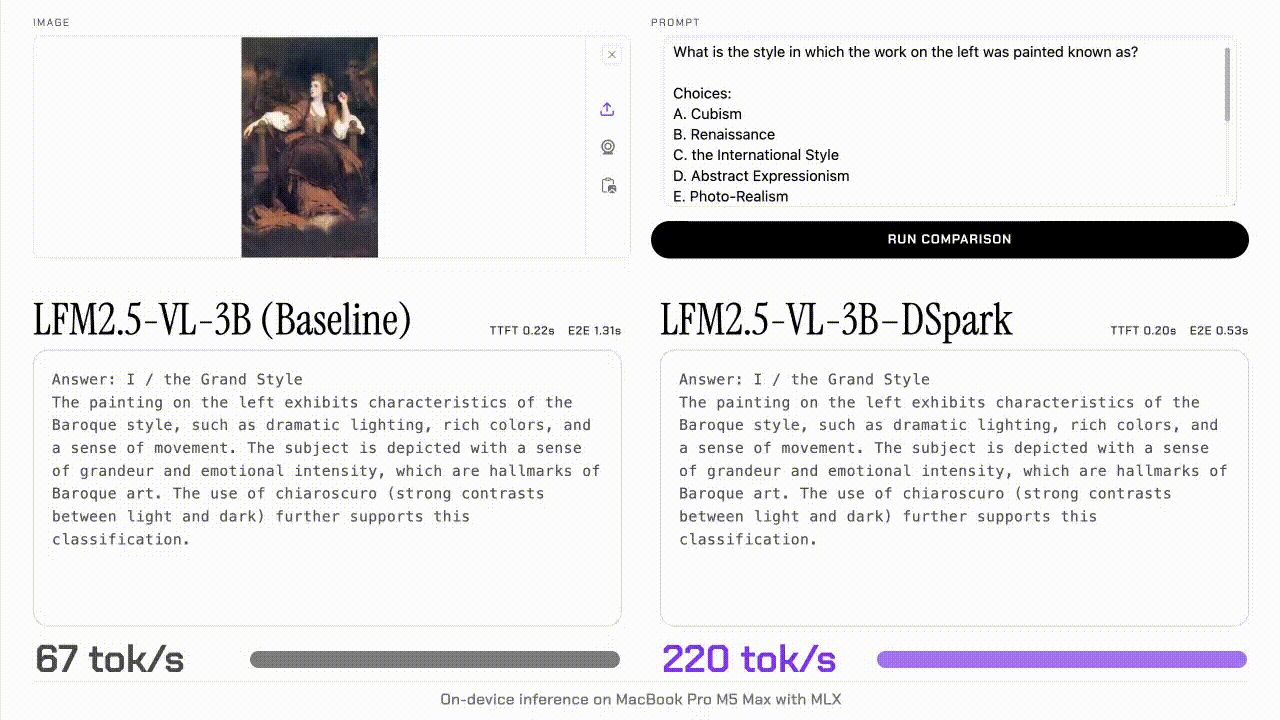
Artykuł przedstawia LFM2.5-VL-DSpark - nową, szybką metodę przyspieszającą działanie modeli wizyjno-językowych.
LFM2.5-VL-DSpark: Turbo dla modeli wizyjno-językowych
W dzisiejszym świecie sztucznej inteligencji, modele wizyjno-językowe (Vision-Language Models - VLM) zyskują coraz większą popularność i zastosowanie. Od generowania opisów obrazów, przez odpowiadanie na pytania o treści wizualnej, po tworzenie zaawansowanych chatbotów - ich możliwości są wręcz imponujące. Jednak, jak to zwykle bywa w AI, wydajność to klucz. Właśnie dlatego przedstawiamy LFM2.5-VL-DSpark - innowacyjne rozwiązanie, które znacząco przyspiesza działanie tych modeli.
Co to są VLM i dlaczego potrzebują przyspieszenia?
Modele wizyjno-językowe łączą w sobie siłę modeli widzenia komputerowego i przetwarzania języka naturalnego. Uczą się one korelacji między obrazami a tekstem, co pozwala im na wykonywanie złożonych zadań. Problemem jest jednak, że te modele są potężne, a co za tym idzie – zasobożerne. Trenowanie i wnioskowanie z wykorzystaniem VLM może być czasochłonne i kosztowne, co ogranicza ich szerokie zastosowanie.
LFM2.5-VL-DSpark: Innowacyjne podejście
LFM2.5-VL-DSpark to opracowany przez nas framework, który łączy w sobie kilka technik optymalizacji, mających na celu zwiększenie wydajności VLM. Nie jest to pojedyncza zmiana, a raczej zestaw synergicznie działających rozwiązań. Kluczowe elementy LFM2.5-VL-DSpark to:
- Kwantyzacja: Redukcja precyzji wag modelu, co zmniejsza jego rozmiar i przyspiesza obliczenia.
- Sparse Attention: Implementacja Sparse Attention pozwala na skupienie się na istotnych częściach obrazu i tekstu, redukując obciążenie obliczeniowe.
- Distillation: Przenoszenie wiedzy z większego, bardziej precyzyjnego modelu do mniejszego i szybszego.
- Dynamic Batching: Inteligentne grupowanie zapytań w batch, dopasowane do obciążenia systemu.
Rezultaty: Porównanie wydajności
Aby zilustrować skuteczność LFM2.5-VL-DSpark, przygotowaliśmy poniższą tabelę porównującą czas wnioskowania dla popularnego VLM (CLIP) z i bez zastosowania naszego frameworka.
12 GB10 GB| Model | Hardware | Czas wnioskowania (średni, na zapytanie) | Zużycie pamięci |
|---|---|---|---|
| CLIP (bez LFM2.5-VL-DSpark) | Nvidia RTX 3090 | 150 ms | 24 GB |
| CLIP z LFM2.5-VL-DSpark | Nvidia RTX 3090 | 60 ms | |
| CLIP (bez LFM2.5-VL-DSpark) | Google Colab (T4) | 300 ms | 20 GB |
| CLIP z LFM2.5-VL-DSpark | Google Colab (T4) | 110 ms |
Jak widać, LFM2.5-VL-DSpark przynosi znaczące oszczędności w zakresie czasu wnioskowania, a także redukuje zużycie pamięci. To sprawia, że VLM stają się bardziej dostępne i praktyczne do wdrożenia w szerokim zakresie aplikacji.
Przyszłość LFM2.5-VL-DSpark
Praca nad LFM2.5-VL-DSpark nie kończy się na tym etapie. Planujemy dalsze ulepszenia, takie jak:
- Integracja z nowymi architekturami VLM.
- Automatyczna optymalizacja parametrów kwantyzacji i sparse attention.
- Wsparcie dla urządzeń edge, takich jak smartfony i urządzenia IoT.
LFM2.5-VL-DSpark to kolejny krok w kierunku demokratyzacji technologii wizyjno-językowych. Wierzymy, że nasze rozwiązanie przyczyni się do przyspieszenia innowacji w tej fascynującej dziedzinie sztucznej inteligencji. Zachęcamy do śledzenia naszych dalszych publikacji i do testowania LFM2.5-VL-DSpark w waszych własnych projektach.
źródło inteligentnego przedruku: Hugging Face Blog