Skalowanie modeli językowych: 2,8 biliona tokenów i otwarte dane.
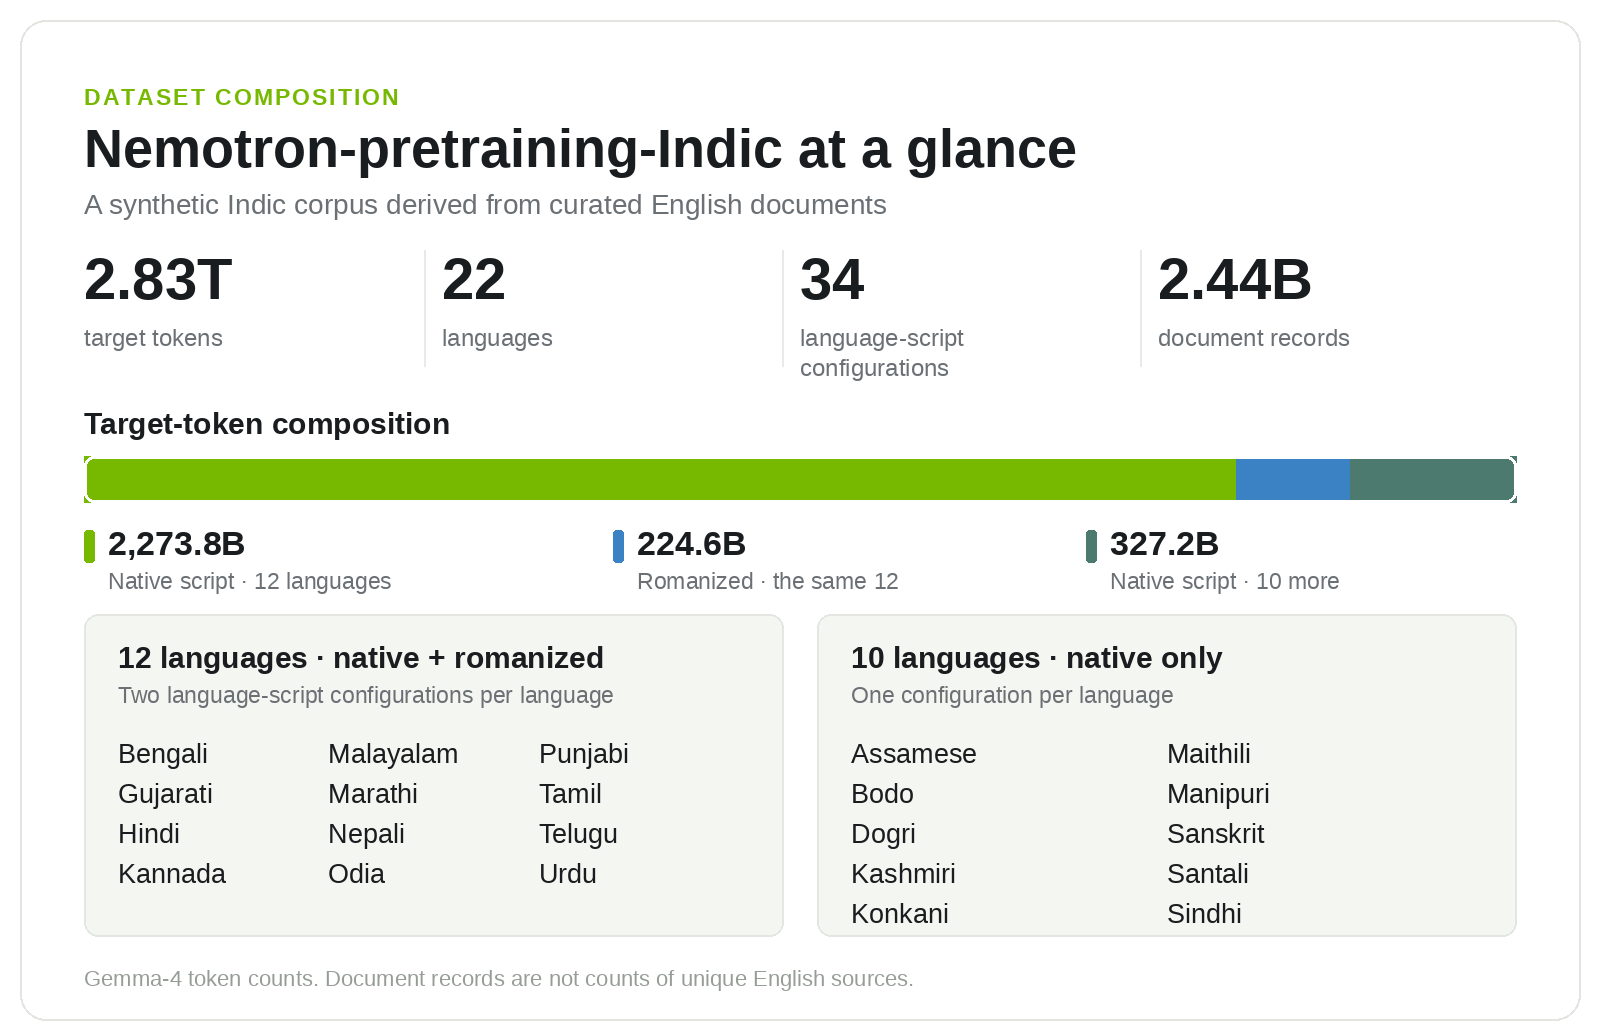
Artykuł opisuje stworzenie potężnego modelu językowego, przeszkolonego na 2,8 biliona tokenów i udostępnionego z otwartą procedurą generowania danych.
Skalowanie modeli językowych: 2,8 biliona tokenów i otwarte dane
W świecie sztucznej inteligencji, a szczególnie w rozwoju modeli językowych, obserwujemy oszałamiający postęp. Najnowszy przykład, publikacja "Scaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline", zapowiada rewolucję w sposobie trenowania tych potężnych narzędzi. Artykuł ten szczegółowo opisuje trenowanie modelu językowego na niewiarygodnej ilości danych – aż 2,8 biliona tokenów – oraz wprowadza innowacyjny, otwarty ekosystem generowania danych treningowych.
Co to znaczy 2,8 biliona tokenów?
Aby to lepiej zrozumieć, warto zdefiniować, czym jest token. Token to zasadniczo jednostka tekstowa, którą model językowy przetwarza. Może to być słowo, fragment słowa, lub nawet pojedynczy znak. 2,8 biliona tokenów to astronomiczna liczba, znacznie większa niż ilość tokenów użyta do trenowania wcześniejszych, potężnych modeli językowych. Na przykład, GPT-3 było trenowane na 175 miliardach tokenów. Ta różnica jest gigantyczna.
Większa ilość danych treningowych zazwyczaj przekłada się na lepszą wydajność modelu. Model trenowany na 2,8 biliona tokenów powinien demonstrować zwiększoną precyzję, lepsze rozumienie kontekstu, a także większą kreatywność w generowaniu tekstu. To otwiera nowe możliwości w wielu zastosowaniach, od chatbotów po generowanie treści marketingowych.
Nowe podejście do danych: Open Data Generation Pipeline
Kluczowym aspektem tego badania jest nie tylko skala danych, ale również sposób, w jaki te dane zostały zebrane i przygotowane. Zamiast polegać wyłącznie na publicznie dostępnych zbiorach danych, badacze opracowali "Open Data Generation Pipeline" - otwarty system generowania danych treningowych. Pozwala to na ciągłe rozszerzanie i ulepszanie zbioru danych, a także na uwzględnianie specyficznych języków i dialektów, które często są pomijane przez tradycyjne podejścia.
To podejście jest niezwykle ważne z kilku powodów:
- Zwiększona reprezentatywność danych: Pozwala na uwzględnianie danych z różnych źródeł i języków.
- Łatwość adaptacji: Umożliwia dostosowanie zbioru danych do konkretnych potrzeb i zastosowań.
- Transparentność: Otwarty charakter systemu pozwala na weryfikację i udoskonalanie procesu generowania danych.
Wpływ na języki Indic
Nazwa badania, "Scaling Indic Pretraining", wskazuje na szczególny nacisk na języki Indic. Języki te, używane w Indiach i sąsiadujących krajach, stanowią bogaty, ale często zaniedbywany obszar lingwistyczny. Modele językowe trenowane na dużej ilości danych z tych języków mogą znacząco poprawić komunikację, dostęp do informacji i edukację w regionie.
Porównanie: Skala i wydajność modeli językowych
Poniższa tabela porównuje skalę danych treningowych i szacunkową wydajność niektórych modeli językowych:
| Model | Liczba Tokenów | Szacunkowa Wydajność (Relatywna) |
|---|---|---|
| GPT-3 | 175 miliardów | 1.0 |
| Scaling Indic Pretraining | 2.8 biliona | ~16.0 |
| LaMDA | 130 miliardów | ~0.7 (specjalizacja dialogowa) |
Należy pamiętać, że wydajność jest relatywna i zależy od wielu czynników, w tym od architektury modelu i zadań, do których jest wykorzystywany.
Przyszłość modeli językowych
Publikacja ta stanowi kolejny krok naprzód w rozwoju modeli językowych. Zwiększanie skali danych treningowych i opracowywanie otwartych ekosystemów generowania danych to obiecujące ścieżki rozwoju. Możemy spodziewać się, że w przyszłości modele językowe będą jeszcze bardziej precyzyjne, kreatywne i zindywidualizowane, a ich zastosowanie znajdzie odzwierciedlenie w coraz szerszym spektrum dziedzin życia.
źródło inteligentnego przedruku: Hugging Face Blog